실습 목표#
- Thread Pool의 빈칸을 채워 Queue와 Worker가 맞물려 돌게 만든다.
- Pool 크기를 바꿔 가며 재고 포화되는 지점을 찾는다.
- Socket Buffer를 바꿔 가며 대용량 전송의 처리량이 포화되는 지점을 찾는다.
과제 1. Queue와 Worker#
accept()로 수락한 연결을 Queue에 넣은 뒤 worker를 활성화해야 한다. 라즈베리파이 ecu_pool_blank.cpp의 main() 함수 내 [BLANK1]을 채워 구현해보자.
int conn = accept(srv, nullptr, nullptr);
if (conn < 0) continue;
{ std::lock_guard<std::mutex> lk(m); q.push(conn); }
// 방금 Queue에 넣었으니 자고 있는 Worker 하나를 깨움
cv./* [[BLANK1]] */;
예시답안 : Queue와 Worker#
Queue에 넣은 직후 Worker 하나를 활성화한다.
{ std::lock_guard<std::mutex> lk(m); q.push(conn); }
cv.notify_one();
make
과제 2. Worker의 대기 조건#
Worker는 Queue에 요청이 왔을 때만 활성화되어아 한다. Condition Variable는 이유 없이 활성화되기도 하므로 조건을 반드시 확인해야 한다.
std::unique_lock<std::mutex> lk(m);
// Queue가 비어 있지 않을 때까지 잠들어 대기
cv.wait(lk, []{ return /* [[BLANK2]] */; });
conn = q.front();
q.pop();
예시 답안 : Worker의 대기 조건#
Queue가 비어 있지 않은 경우에만 활성화되어 다음으로 처리로 진행한다. 조건이 충족되지 않으면 대기 상태로 복귀하므로 가짜 기상이 발생해도 안전하게 처리된다.
cv.wait(lk, []{ return !q.empty(); });
make
./ecu_pool_blank 1000 1024 0 4
관찰 포인트
인자는 순서대로 처리 지연, App Buffer, Socket Buffer, Pool 크기.
실습 1. Pool 크기 스윕#
Worker 수만 변경하며 동일한 부하를 적용하여 측정한다. 동시 클라이언트 수는 10으로 고정하고 Pool 크기만 1에서 16까지 증가시킨다.
./ecu_pool_blank 1000 1024 0 1
./ecu_pool_blank 1000 1024 0 4
./ecu_pool_blank 1000 1024 0 16
./load_client 192.168.10.2 10 100
Pool 크기 |
처리량 (req/s) |
지연 p99 (μs) |
|---|---|---|
| 1 | ||
| 4 | ||
| 16 | ||
| 직접 정한 값 |
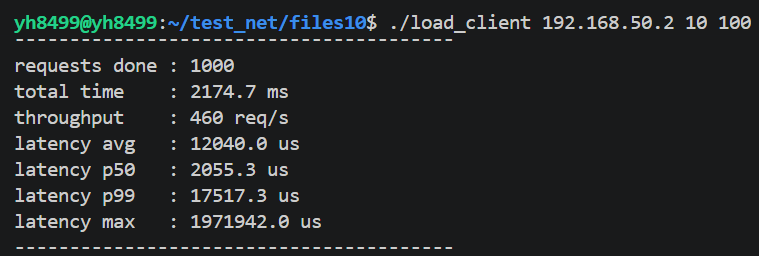
풀 크기 1#
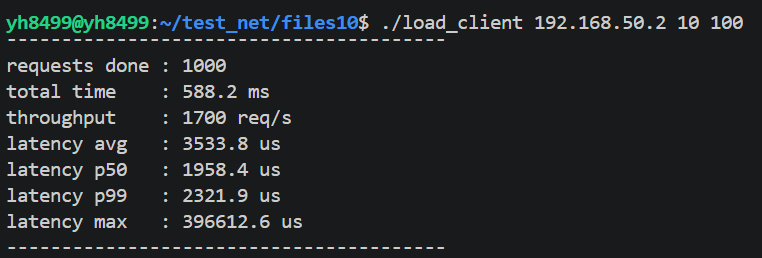
풀 크기 4#
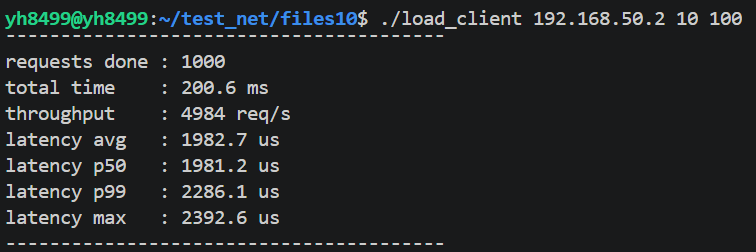
풀 크기 16#
결과 : Pool 크기와 처리량#
Pool 크기 증가에 비례하여 처리량이 향상되며, Worker 수에 비례하여 동시 처리 능력이 확대된다. 다만 무한정 증가하지는 않으며, 동시 연결 수 근처에서 포화 상태에 도달한다.
확인할 것
위 수치는 참고값이다. 실제 측정 결과는 장비 성능과 실행 환경에 따라 달라질 수 있다.
분석: 최적 Pool 크기#
Worker 수가 동시 연결 수보다 많으면 남는 Worker는 처리할 작업 없이 대기한다. 반면, Worker가 동시 연결 수보다 적으면 일부 연결이 Queue에서 차례를 기다린다.
Pool 크기 |
발생하는 상황 | 결과 |
|---|---|---|
| 동시 연결보다 적음 | 일부 연결이 Queue에서 차례를 기다림 |
처리량 감소 |
| 동시 연결과 비슷함 | 모든 연결이 곧바로 Worker를 얻음 |
가장 좋은 지점 |
| 동시 연결보다 많음 | 남는 Worker가 작업 없이 대기함 |
처리량이 더 증가하지 않음 |
Core 수보다 훨씬 많음 |
문맥 전환 비용이 증가함 | 오히려 성능이 낮아질 수 있음 |
추가 실험
동시 클라이언트를 10으로 고정하고 Pool 크기를 8, 10, 12, 16으로 바꿔 측정하면 처리량이 포화되는 지점을 확인할 수 있다.
실습 2. Socket Buffer 스윕#
1 MB 응답을 수신하는 과정에서 Socket 수신 버퍼의 크기만 변경하며 처리량을 측정한다. App Buffer는 4 KB로 고정하고 Socket Buffer만 변경한다.
make
./bulk_server 1024
make
./bulk_client 192.168.10.2 1024 4096 4096   30
./bulk_client 192.168.10.2 1024 4096 65536  30
./bulk_client 192.168.10.2 1024 4096 262144 30
명령어 인자
bulk_client의 인자는 서버 주소, 응답 크기, App Buffer, Socket Buffer, 반복 횟수 순서이다.
요청한 Socket Buffer |
커널이 적용한 값 | 처리량 (MB/s) |
|---|---|---|
4 KB |
||
64 KB |
||
256 KB |
||
| 직접 정한 값 |
SO_RCVBUF 4KB#

SO_RCVBUF 64KB#
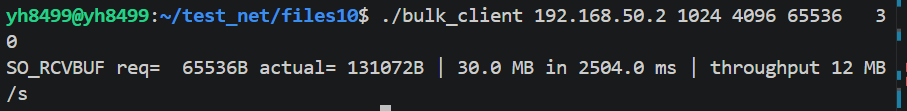
SO_RCVBUF 256KB#
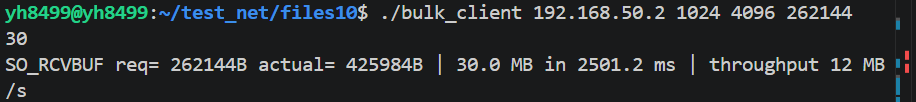
관찰 포인트
요청한 버퍼 크기와 커널이 실제로 적용한 버퍼 크기가 같은지 확인한다. 운영체제에 따라 커널이 요청값보다 크게 설정할 수 있다.
측정이 끝나면 라즈베리파이 터미널에서 Ctrl+C를 눌러 서버를 종료한다.
실습 2 결과: Buffer와 처리량#
Buffer크기가 작을수록 처리량이 크게 저하되고, 크기를 증가시킬수록 처리량이 빠르게 향상된다. 다만 버퍼 크기가 일정 수준을 초과하면 처리량이 더 이상 증가하지 않는다.
확인할 것
위 수치는 참고값이다. 실제 처리량은 장비 성능과 네트워크 환경에 따라 달라질 수 있다. 측정값이 더 증가하지 않는 첫 지점을 실용적인 버퍼 크기로 본다.
분석: 지연과 Buffer 크기#
필요한 Buffer 크기는 고정된 값이 아니며 네트워크 속도와 왕복 시간(RTT)에 따라 달라진다. 직결 환경은 왕복 시간이 짧아 소규모 Buffer로도 처리량이 빠르게 포화 상태에 도달한다. 반면 지연이 큰 환경에서는 동일한 데이터를 전송하기 위해 더 큰 Buffer가 필요하다.
| 환경 | 필요한 Buffer |
캡처에서 확인할 내용 |
|---|---|---|
| 직결 환경 · 지연이 거의 없음 | 64 KB 정도에서 포화될 수 있음 |
Window 값이 충분하고 전송이 막히지 않음 |
| 지연이 큰 환경 | 더 큰 Buffer가 필요함 |
작은 Window에서는 TCP Window Full이 반복될 수 있음 |
Wireshark 관찰 포인트
Socket Buffer가 작을 때와 클 때의 Win 값과 TCP Window Full 발생 여부를 비교한다.
실습 정리#
| 튜닝 대상 | 적용 원칙 | 실습에서 확인한 근거 |
|---|---|---|
Thread 방식 |
연결마다 Thread를 만들지 않고 Thread Pool을 사용함 |
생성되는 Thread 수를 제한할 수 있음 |
Pool 크기 |
예상 동시 연결 수에 맞추고 Core 수도 고려함 |
일정 크기 이후 처리량이 포화됨 |
Socket Buffer |
네트워크 속도와 왕복 시간에 맞춰 조정함 | 작은 버퍼에서는 처리량이 낮고 일정 크기 이후 포화됨 |
| 제어기 메모리 | 버퍼와 Pool을 무조건 크게 설정하지 않음 |
통신에 사용하는 메모리가 늘면 다른 기능에 사용할 메모리가 줄어듦 |
핵심
가장 큰 값을 선택하는 것이 아니라, 처리량이 더 이상 크게 증가하지 않는 첫 지점을 찾는다.